Der ALASCA Tech Stack
Aus Europa. Für Europa.
Dr. Daniel Gerber
26. August 2026
ALASCA Tech Stack
- Überblick
- Unsere Projekte
- Organisches Wachstum
- Diskussionsbeitrag
Der Stack auf einen Blick
Tarook — Lifecycle Management für Kubernetes
Tarook ist eine CNCF-zertifizierte Kubernetes-Distribution mit ganzheitlichem Lifecycle Management. Es kann hochverfügbare Cluster ausrollen, betreiben und skalieren: auf Bare Metal, OpenStack und Proxmox.
Projektverantwortliche
- Bruno SchubertCloud & Heat
- Silvio AnkermannCloud & Heat
- Steve StarkeCloud & Heat
Geschrieben in
Nix Ansible Terraform Python
Lizenz
Apache-2.0
Wo es zu finden ist
- Code gitlab.com/alasca.cloud/tarook/tarook
- Docs docs.tarook.cloud
- Mailingliste tarook@lists.alasca.cloud
Warum Tarook einsetzen?
Herausforderungen
Komplexe Installation
Sobald Hochverfügbarkeit und Skalierbarkeit gefordert sind, wird das Aufsetzen eines Clusters aufwendig.
Schnelles Ökosystem
Werkzeuge, Versionen und Empfehlungen ändern sich laufend; den Überblick zu behalten kostet Aufwand.
Lösung
Wächst einfach mit
Skalierbarkeit und Hochverfügbarkeit sind vorgesehen; steigende Anforderungen erfordern keinen Umbau.
Best Practices inklusive
Tarook führt Kubernetes und die zugehörigen Dienste durch ihren Lifecycle und stellt regelmäßige Updates bereit.
Einsatzbereich
Cluster-Management
Bereitstellung, Verwaltung und Skalierung erfolgen auf Bare Metal, OpenStack & Proxmox nach demselben Ablauf.
Certified Kubernetes
Von der CNCF zertifiziert für Kubernetes 1.34 bis 1.36 und interoperabel mit anderen zertifizierten Distributionen.
8 gute Gründe für Tarook
Einfache Bereitstellung
Kubernetes auf OpenStack oder Bare Metal, gesteuert über eine zentrale Konfiguration.
Skalierbar und flexibel
Nix-basierte Konfiguration, wählbare Storage-Lösungen und ein eigener Load Balancer als Alternative zu Octavia.
Hochverfügbar
keepalived und HAProxy sichern den Kubernetes-Endpunkt ab.
Secrets und Identitäten
Zertifikate und Zugriffsrechte werden über HashiCorp Vault automatisiert verwaltet.
Modularer Aufbau
k8s-core betreibt den kubeadm-Cluster, die k8s-supplements ergänzen den Produktivbetrieb.
GPU und vGPU
NVIDIA-Unterstützung für rechenintensive Workloads einschließlich KI-Training.
Tools schon integriert
NGINX Ingress, Cert-Manager, Flux, Prometheus, Rook/Ceph, Calico und etcd-Backups sind integriert.
Open Source
Vollständig quelloffen; Entwicklung und Änderungen sind öffentlich nachvollziehbar.
Krake — Workload-Scheduling über Cloud-Grenzen hinweg
Krake ist ein Orchestrator für containerisierte und virtualisierte Workloads über Multi-Cloud, Private Cloud und On-Premises hinweg — verteilt nach den Metriken, die du wählst: ökologisch, technisch oder wirtschaftlich.
Projektverantwortliche
- Patrick ThiemCloud & Heat
Geschrieben in
Python Jinja
Lizenz
Apache-2.0
Wo es zu finden ist
Warum Krake einsetzen?
Herausforderungen
Container-Management
Die Verwaltung von Containern über verteilte Infrastrukturen erfordert eine übergreifende Orchestrierung.
Energieeffizienz
Rechenintensive Workloads, insbesondere KI, erhöhen Energiekosten und CO₂-Emissionen.
Lösung
Zentrale Steuerung
Eine Schnittstelle für verteilte Kubernetes-Cluster, standortübergreifend und automatisiert.
Flexible Optimierung
Die Gewichtung erfolgt anhand konfigurierbarer Metriken wie Leistung, Kosten, Energie und Sicherheit.
Einsatzbereich
Anwendungsszenarien
Von der lokalen Entwicklungsumgebung bis zum verteilten Produktivsystem, vom Microservice bis zum KI-Training.
Sächsischer Digitalpreis 2024 — Open Source
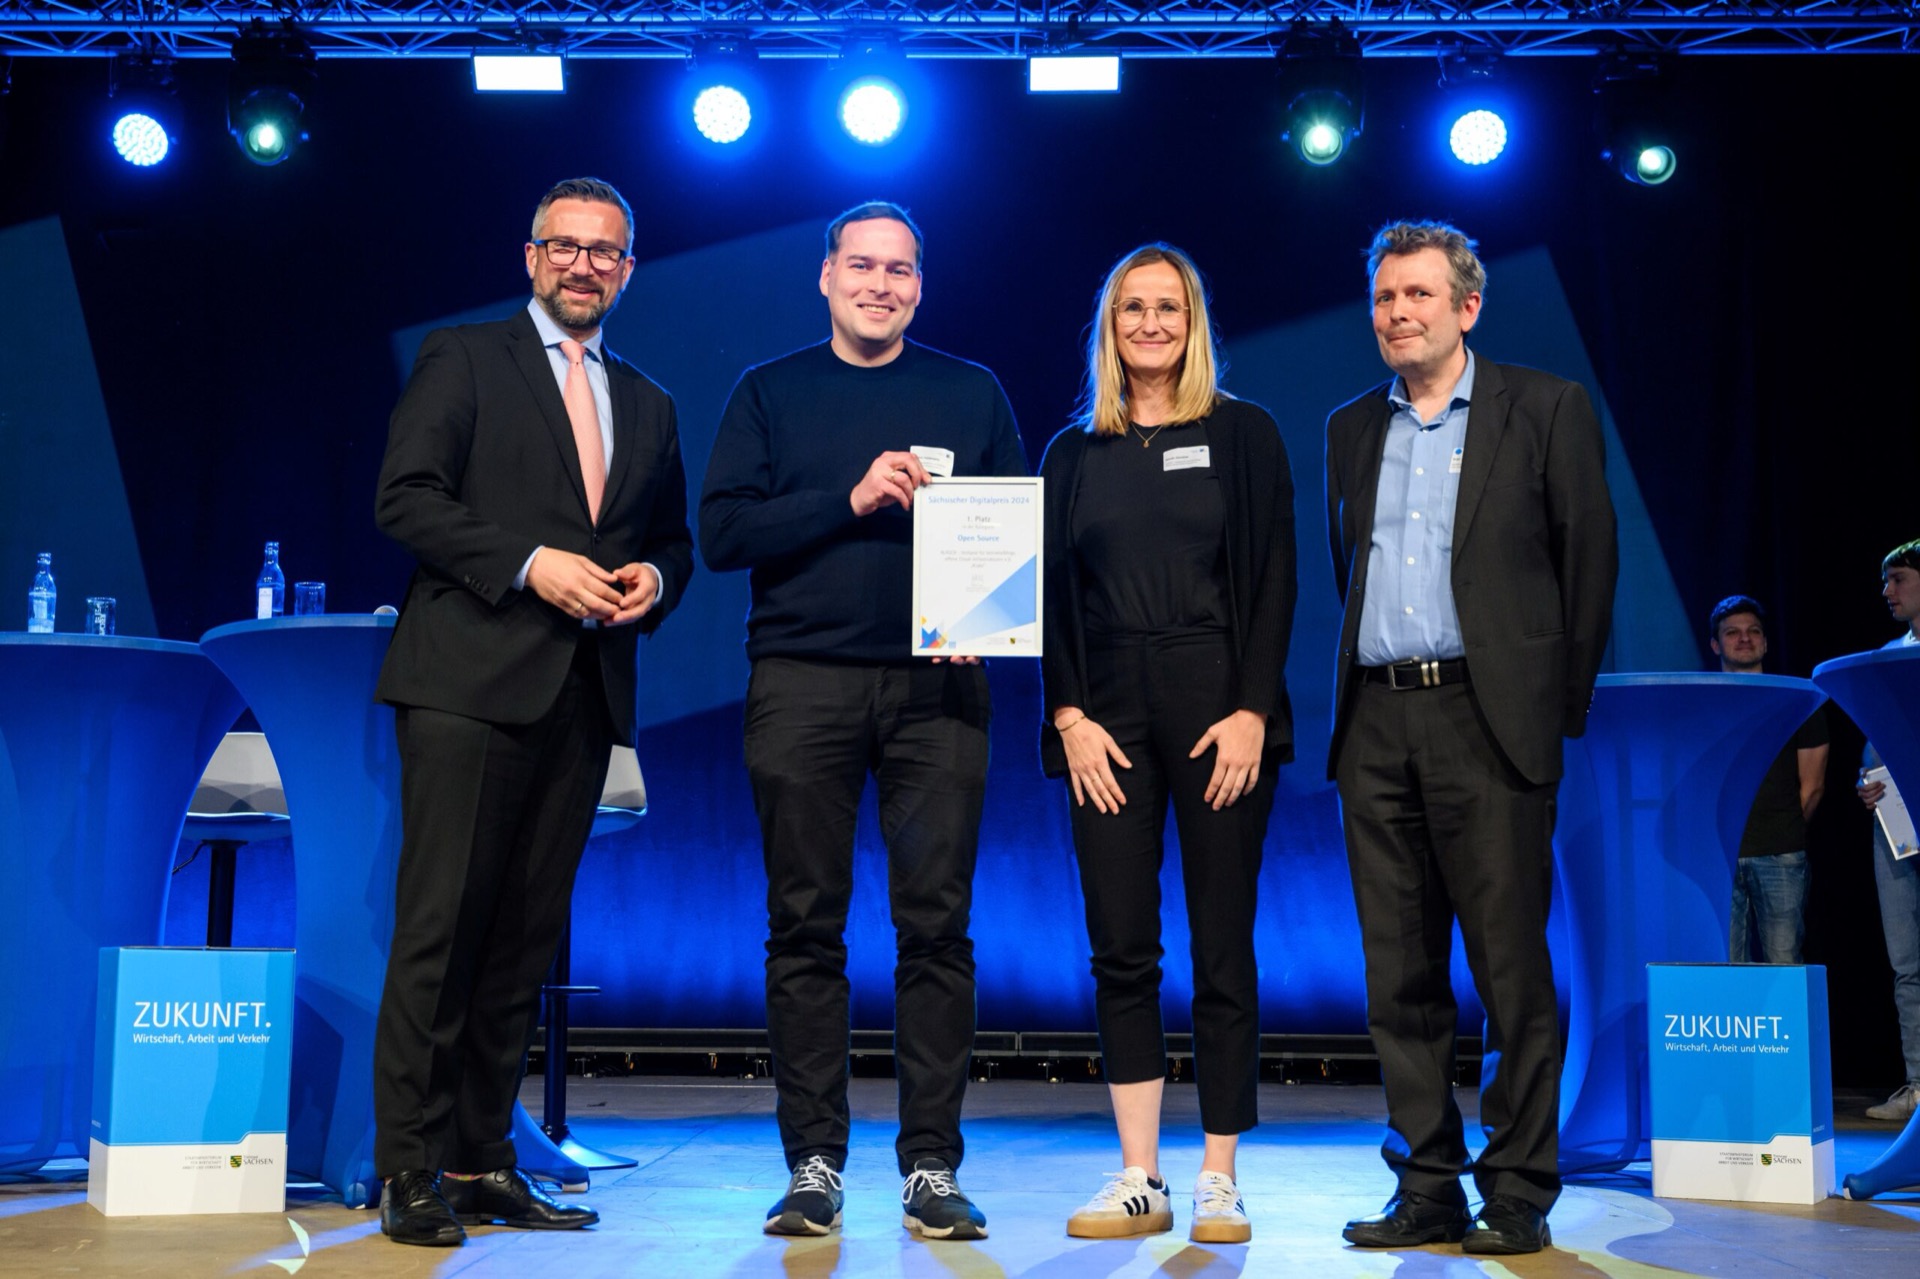
Foto: © BLEND3 Frank Grätz
8 gute Gründe für Krake
Einheitliche Schnittstelle
Verteilte Kubernetes-Cluster werden über eine zentrale Abstraktionsebene verwaltet.
Modulare Architektur
Microservice-basierte Komponenten; eigene Entwicklungen lassen sich in die Orchestrierungs-Pipeline einbinden.
Kubernetes-fokussiert
Orchestrierung von Kubernetes-Workloads über verschiedene Cluster und Standorte hinweg.
Intelligentes Scheduling
Die Verteilung folgt konfigurierbaren Metriken wie Latenz, Energie und Kosten sowie selbst definierten Parametern.
Label-basiertes Scheduling
Labels und Constraints steuern feingranular, welche Workloads auf welchen Clustern ausgeführt werden.
Zustandslos und zustandsbehaftet
Orchestriert werden zustandslose wie zustandsbehaftete Workloads, vom Microservice bis zum Datenbanksystem.
Infrastruktur-Provisionierung
Kubernetes-Cluster werden bei verschiedenen Infrastruktur-Providern automatisiert bereitgestellt und skaliert.
Sächsischer Digitalpreis 2024
Ausgezeichnet in der Kategorie Open Source, nominiert von der Fachjury und gewählt im Publikumsvoting.
Yake — Installer und Lifecycle-Tool für Gardener
Yake ist ein GitOps-getriebener Installer und Lifecycle-Manager für Gardener. Flux gleicht das laufende System fortlaufend mit der deklarativen Konfiguration in Git ab — Deployment und Upgrade sind derselbe Routinevorgang.
Projektverantwortliche
- Christian Berendt23technologies
Geschrieben in
Go Go Template Shell Mustache
Lizenz
Apache-2.0
Wo es zu finden ist
- Code github.com/yakecloud/yake
- Docs yake.cloud/docs
Warum Yake einsetzen?
Herausforderungen
Gardener aufsetzen
Provisionierung, Lifecycle-Management und Day-2-Operations sind zeitaufwendig, bevor der erste Cluster steht.
Spezialwissen
Der Betrieb erfordert Kenntnisse vieler Komponenten, was die Einführung erschwert.
Lösung
In Minuten startklar
Skripte erzeugen eine Basiskonfiguration, die andernfalls schrittweise manuell erstellt werden muss.
Git ist die Wahrheit
Der GitOps-Workflow hält die Installation deklarativ; Änderungen sind nachvollziehbar und wiederholbar.
Einsatzbereich
Self-hosted Gardener
Für Organisationen, die Gardener als eigene Kubernetes-Control-Plane betreiben, statt sie als Dienst zu beziehen.
Updates als Routine
Upgrade-Guides beschreiben den Wechsel zwischen Versionen und halten den Aktualisierungsaufwand gering.
4 gute Gründe für Yake
Schnelles Bootstrapping
Die Helper-Skripte erstellen aus dem Repository eine lauffähige Basisinstallation.
Deklarative Konfiguration
Die gesamte Gardener-Installation liegt als Konfiguration in Git vor und ist damit nachvollziehbar.
Einfache Updates
Upgrade-Guides führen durch die einzelnen Versionswechsel.
Zentrale Steuerung
Eine Control Plane für die selbst gehostete Gardener-Installation, an einer Stelle verwaltet.
Yet another OpenStack on K8s — Angstfreie Automatisierung
Yaook bietet ein vollständig automatisiertes OpenStack Lifecycle Management für die Bereitstellung und den Betrieb eigener Cloud-Infrastrukturen.
Projektverantwortliche
- Stefan HoffmannCloud & Heat
- Max HarmathyUhurutec
Geschrieben in
Python Cue Shell Jinja
Lizenz
Apache-2.0
Wo es zu finden ist
- Code gitlab.com/yaook/operator
- Docs docs.yaook.cloud
- Mailingliste yaook@lists.alasca.cloud
Warum Yaook einsetzen?
Herausforderungen
Skalierbarkeit
Wächst eine Cloud, muss die Control Plane mitwachsen, ohne dass die Verfügbarkeit beeinträchtigt wird.
Komplexe Konfiguration
Sonderkonfigurationen für Hardware, Netzwerke und Dienste sammeln sich an und werden unübersichtlich.
Lösung
Operatoren
Controller-Pattern aus Kubernetes: Label-Änderungen greifen im laufenden Betrieb ohne Ausfallzeit.
Eindeutige Konfiguration
Optionen sind an Labels der Knoten gebunden. Widersprüche werden abgelehnt und nicht zusammengeführt.
Einsatzbereich
Anwendungsszenarien
Einsetzbar in jeder Umgebung, in der Kubernetes betrieben wird.
Sovereign Cloud Stack
Yaook kann eingesetzt werden, um SCS-konformes OpenStack zu betreiben.
8 gute Gründe für Yaook
Kubernetes-nativ
Läuft in Kubernetes und nutzt dessen Funktionen; unterstützt IPv4-only, IPv6-only und Dual-Stack.
Automatisiertes „Tag 2“
Die Operatoren übernehmen den laufenden Betrieb, etwa den Austausch ausgefallener Knoten und Versionsupgrades.
Risiko-avers
Datenverändernde Operationen erfolgen nur auf ausdrückliche Anweisung und nur, wenn keine Alternative besteht.
Label-basierte Verteilung
Nahezu jede Komponente lässt sich über Labels und Taints platzieren.
Standardmäßig gesichert
Die gesamte clusterinterne Kommunikation ist TLS-verschlüsselt und wird vom Cert Manager verwaltet.
Mix & Match
Die benötigten OpenStack-Dienste lassen sich einzeln auswählen, von einer minimalen bis zur vollständigen Installation.
Vollständig anpassbar
Jedes Container-Image lässt sich durch ein eigenes ersetzen.
Open-Source
Yaook ist vollständig quelloffen; Entwicklung und Änderungen sind öffentlich nachvollziehbar.
Seconlay — minimales IaaS mit strikter Mandantentrennung
Seconlay ist eine in Rust gebaute Infrastructure-as-a-Service-Schicht für sichere Mandantentrennung: eine bewusst minimale Trusted Computing Base, mit strikt von der Data Plane getrennter Control Plane.
Projektverantwortliche
- Felix WalterD3TN
- Georg Alexander MurzikD3TN
Geschrieben in
Rust Nix Go
Lizenz
EUPL-1.2
Wo es zu finden ist
Warum Seconlay einsetzen?
Herausforderungen
Gemeinsame Hardware
Fremde Workloads auf derselben Hardware sicher zu trennen, bleibt mit klassischem IaaS schwierig.
Teure Workarounds
Physische Trennung gleicht Komplexität und schlechte Auditierbarkeit aus und verursacht Kosten.
Lösung
Schlanke TCB
In Rust implementiert, mit bewusst kleiner Trusted Computing Base.
Getrennte Ebenen
Control Plane und Data Plane sind strikt getrennt, für erhöhte Sicherheitsanforderungen.
Vorteile
Ausfallsicher
Ein Cluster umfasst mehrere Maschinen und bleibt beim Ausfall einzelner Knoten verfügbar.
Deklarativ steuerbar
Deklarative API, selbstheilendes Verhalten und ein Terraform-Provider.
Arko — Monitoring für hybride Cloud-Infrastruktur
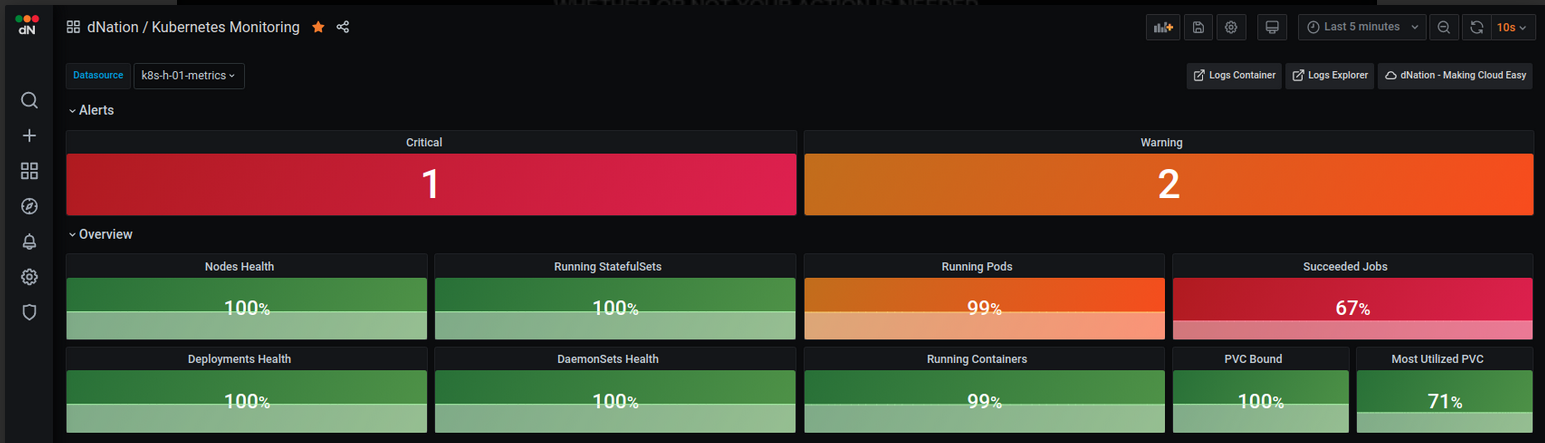
Arko ist eine standardisierte Monitoring-Plattform für hybride Clouds: der Zustand von Systemen und Anwendungen über private und öffentliche Umgebungen hinweg auf einen Blick, mit Drill-down-Analysen, die den Fehler finden statt ihn nur anzuzeigen.
Projektverantwortliche
- Ivan VnuckodNation
- Roman HrosdNation
Geschrieben in
Jsonnet Go Template Shell
Lizenz
Apache-2.0
Wo es zu finden ist
Warum Arko einsetzen?
Herausforderungen
Hybride Infrastruktur
Der Zustand von Azure, Google und On-Premise ist über mehrere Konsolen verteilt.
Kein Vendor Lock-in
Eine Überwachung auf quelloffener Basis soll ohne Bindung an einen einzelnen Anbieter möglich sein.
Lösung
Intuitiv
🟢 Grün, 🟠 orange, 🔴 rot - Ein dreistufiger Farbcode zeigt an, ob Handlungsbedarf besteht.
Nur das Relevante
Jede Ebene zeigt ausschließlich die für sie relevanten Metriken.
Einsatzbereich
Hierarchischer Drill-down
Von der Übersicht bis zum einzelnen Container lassen sich Details schrittweise aufrufen.
8 gute Gründe für Arko
20+ Plattformen & Apps
Vorkonfigurierte Dashboards für über zwanzig Plattformen und Anwendungen.
10+ Alert-Kanäle
Benachrichtigungen lassen sich über mehr als zehn Kanäle ausliefern.
Ampel-Status
🟢 Grün, 🟠 orange, 🔴 rot - Ein dreistufiger Farbcode zeigt den Status je Ebene an.
Nur relevante Metriken
Jede Ebene zeigt ausschließlich die für sie relevanten Metriken.
Drill-down
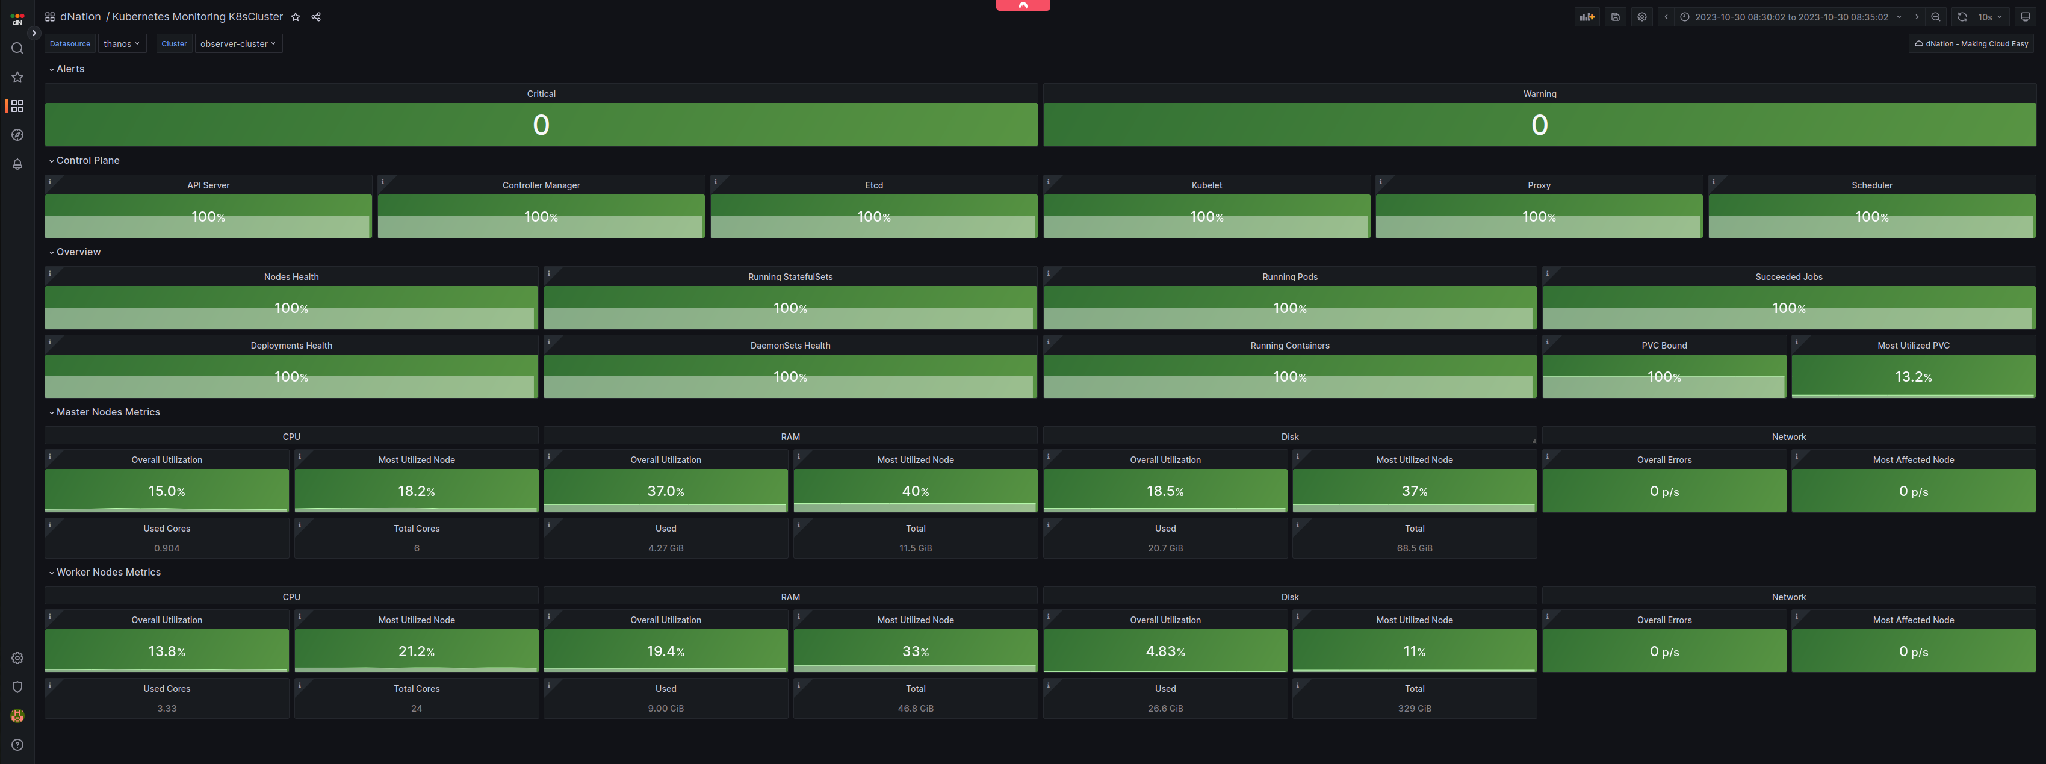
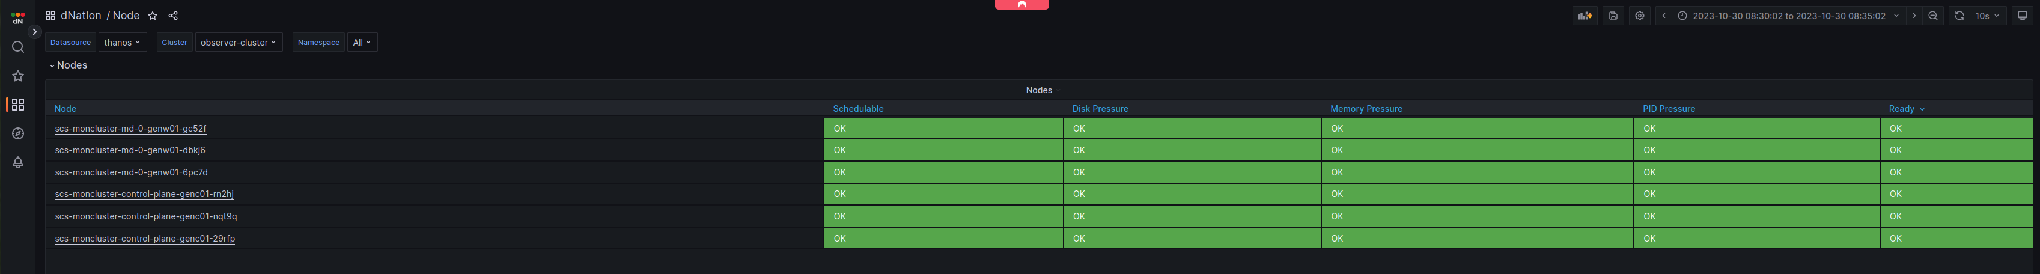
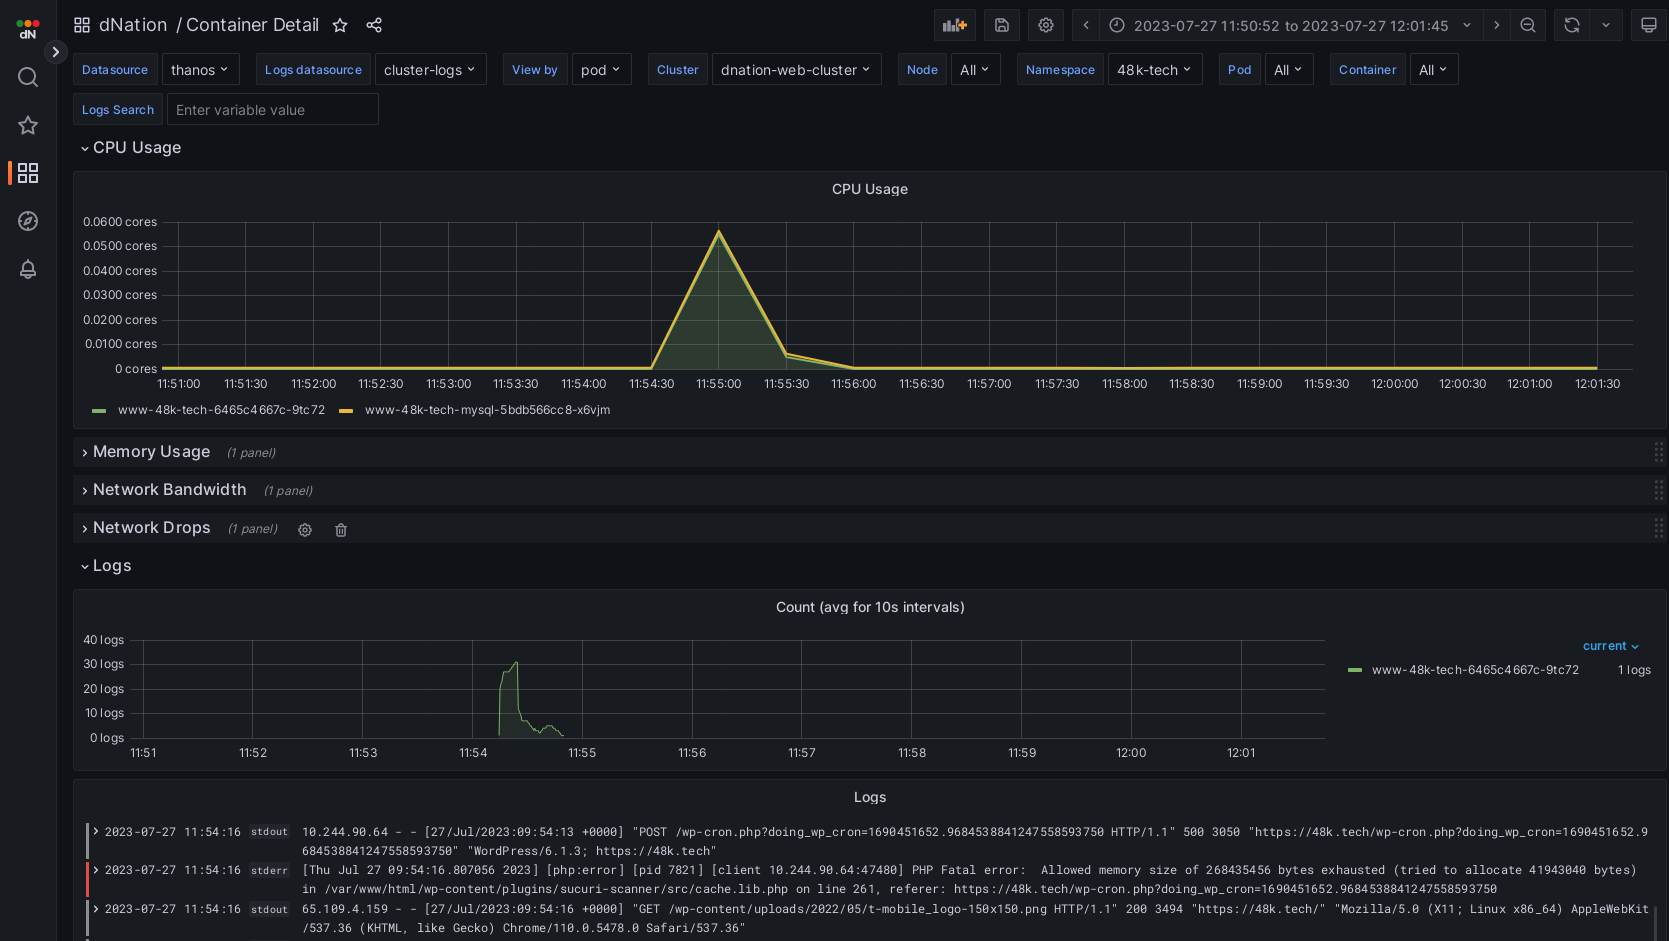
Vier Ebenen von der Übersicht bis zum einzelnen Container.
Logs neben Metriken
Auslastungswerte und Logmeldungen werden auf einer gemeinsamen Zeitachse dargestellt.
Hybrid
Public-Cloud- und On-Premise-Systeme werden in einer gemeinsamen Ansicht dargestellt.
Open Source
Basiert auf Grafana, Prometheus und Loki; eine Bindung an einen Anbieter entsteht nicht.
Ebene 0 — die Übersicht
Ebene 1 — der Cluster
Ebene 2 — die Knoten
Ebene 3 — der Container
IXpect — kontinuierliches Monitoring von IXP-Peering-LANs
IXpect überwacht die Peering-LANs von Internet Exchanges fortlaufend. Es analysiert BUM-Traffic, um Fehlkonfigurationen und Angriffe zu erkennen, zieht die Konfigurationsdaten der Router hinzu und meldet die Funde an einer Stelle.
Projektverantwortliche
- Marcel KochDD-IX
- Thomas LiskeDD-IX
Geschrieben in
Rust Nix Python Jinja
Lizenz
GPL-2.0
Wo es zu finden ist
- Code codeberg.org/ixpect/ixpect
- Docs ixpect.net
- Issues codeberg.org/ixpect/ixpect/issues
Warum IXpect einsetzen?
Herausforderungen
Fehlkonfigurierte Router
Eine fehlerhafte Konfiguration an der Netzgrenze stört das Routing zwischen allen Netzen am IXP.
Schwer zu finden
Solche Störungen mindern die Leistung, sind schwer zu lokalisieren und bleiben häufig unentdeckt.
Lösung
BUM-Traffic lesen
IXpect wertet den BUM-Traffic im Peering-LAN aus; Fehlkonfigurationen und Angriffe zeigen dort auffällige Muster.
Meldung ans NOC
Vorfälle werden protokolliert und je nach Schweregrad per E-Mail, Matrix oder HTTP-Callout gemeldet.
Vorteile
Ein Tool statt vieler
Die Analysen von arpwatch, IXP-watch und ndmon sind in einem Werkzeug zusammengeführt.
Kennt die Router
Die Netzwerkparameter werden aus dem bestehenden IXP Manager übernommen; ein zweiter Datenbestand entfällt.
Organisches Wachstum - ALASCAs 🧊⛏️ Ice Picks
Thanos Helm chart
Nach der Einschränkung der Bitnami-Images fehlte Arko und Tarook die Grundlage. Der Community-Build bezieht Thanos direkt vom Upstream und wird täglich neu erstellt.
SONiC Community Build (SCOMB)
Das kommerzielle SONiC ist plattformgebunden, lizenzpflichtig und nicht quelloffen. ALASCA erstellt einen offenen und dokumentierten Community-Build.
GitLab Fleeting Plugin für OpenStack
Skaliert GitLab-Runner auf OpenStack. Worker-Instanzen werden entsprechend der Pipeline-Last erzeugt und wieder abgebaut.
Woodpecker CI
Quelloffene CI-Software aus dem Upstream-Projekt, betrieben in eigener Infrastruktur und unabhängig von Microsoft und GitLab.
EU Tech Sovereignity Package
-
Chips Act 2.0, Cloud and AI Development Act, EU Open Source
Strategy
- FuEuI: Unterstützung der Entwicklung modernster Cloud- und KI-Technologien der nächsten Generation
- Kapazität: 3x Rechenzentrumskapazität der EU in 5 bis 7 Jahren
- Autonomie: Förderung von Open-Source-Lösungen zur Stärkung der Resilienz
-
Chips Act 2.0 - Stimulierung der Nachfrage und der Industrieakzeptanz
„Schaffung von Synergien mit dem Cloud and AI Development Act, um von der Nachfrage nach europäischen Chips zu profitieren, die sich aus dem Wachstum von Sektoren wie Rechenzentren, Cloud-Service-Providern und KI-Gigafactories ergeben.“ Chips Act 2.0 — Europäische Kommission
Thank you. Stay in touch.
Web
- Website alasca.cloud
- Docs docs.alasca.cloud
- Summit 2026 alasca.cloud/alasca-summit-2026
- Tech-Talks alasca.cloud/alasca-tech-talks
- Podcast alasca.cloud/alasca-opensnac-der-podcast
- GitLab gitlab.com/alasca.cloud
Community
- Mastodon mastodon.social/@alasca
- LinkedIn linkedin.com/company/alasca-cloud
- Mailing lists lists.alasca.cloud
- Matrix #ALASCA:matrix.org
- YouTube youtube.com/@alasca_e.V.